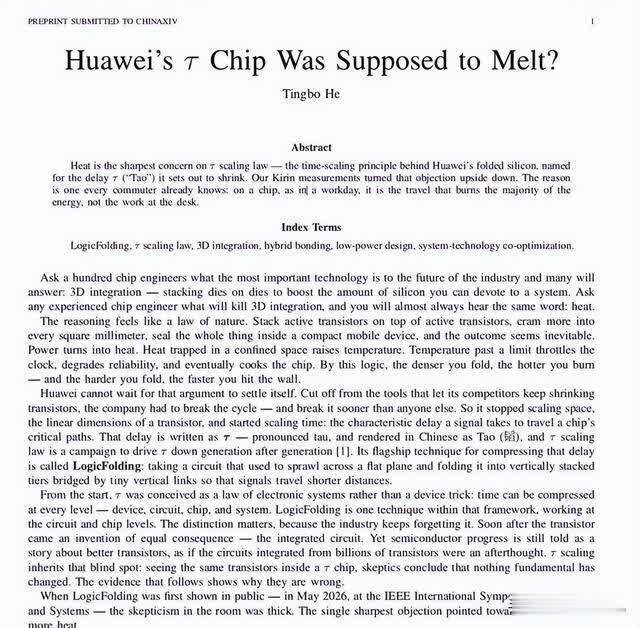
9月4日,何庭波在中科院ChinaXiv预印本平台发布了韬定律的第三篇论文:《Huawei's τ Chip Was Supposed to Melt?》(华为的τ芯片本该熔化?)。这是继今年5月ISCAS 2026上首次提出τ缩放理论、7月V2补充工程数据之后,华为半导体业务部总裁第三次向全球公开这套中国公司原创的芯片理论体系。
最让同行吃惊的,不是标题,而是实测数据!
一、V3到底放出了哪些"底牌"
麒麟2026作为首款落地"逻辑折叠(LogicFolding)"的移动SoC,实测数据如下:
晶体管密度从1.55亿/平方毫米提升至2.38亿/平方毫米,单代提升55%
同等性能下,NPU功耗降66%、GPU降58%、CPU大核降41%
NPU在维持29 TOPS算力时,运行频率降低63%,电压从0.85V降至0.55V
麒麟2026采用1.5微米混合键合(通俗理解就是多层芯片堆叠互联的导线间距)节距,约5000万个垂直互连;下一代麒麟2027实测硅片已达成1微米键合节距,垂直互连突破1亿根
何庭波在论文里专门回应了行业最大的质疑:"3D堆叠必发热烧毁"。她的解释是:现代芯片能耗大头不是晶体管在计算,而是数据在芯片内部"通勤",横着跑长导线时特别费电发热。而逻辑折叠+3D混合键合把电路竖起来叠,数据改走垂直短通道。路近了,延迟和功耗都能降下来。典型核心布线长度减少20%,部分关键路径最高缩短70%。
但她也给了清醒剂:韬定律不是"堆叠自动省电",乱堆照样翻车。失败案例是DSP模块第一代折叠设计里,总功耗降了25%,但因为面积缩小了40%,功耗密度反而上升24%。这说明逻辑折叠对并行度高的负载收益最大,对串行任务收益有限。这也是CPU大核只降41%的根本原因。
该论文还是预印本,尚未过同行评审。但这是中国公司在后摩尔时代,拿实测数据交出的一套自研理论框架。
二、华为6年381款芯片的"工程秘方"
很多人看到这里会问:韬定律的"逻辑折叠"、"3D混合键合"、"以时间τ缩微替代几何缩微"这些原则,何庭波已经一步步都公开了。如果美国系同行拿到论文,能不能直接在3纳米甚至1.5纳米上用韬定律,做出"等效1纳米"甚至更低等效制程的芯片,反而把华为甩在身后更远?
答案是:看得懂,但做不到。
华为的底气第一层,是6年381款量产芯片堆叠出来的工程秘方。从2020年5月到2026年5月,华为基于τ缩放理论已经量产381款芯片,覆盖手机SoC、AI加速器、系统互联、封装技术。这是一个完整的、连续6年的、被迫全栈自研的“修炼场”。
而美国系同行并没有这个修炼场。原因很现实:
第一,没有"被制裁"的外部压力。台积电、英伟达、苹果、英特尔仍然能买到ASML的EUV,仍然能在2纳米、1.5纳米的赛道上正常迭代。他们的组织模式是"分工协作":芯片设计公司、晶圆厂、EDA厂商、IP供应商各管一段。要做逻辑折叠,需要重构整个产业链的利益分配和协作模式,这在资本主义分工体系里几乎是不可能完成的任务。
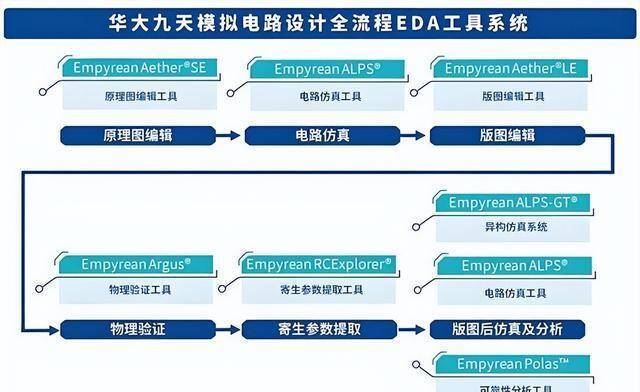
第二,没有"重构EDA工具链的迫切需要"。华为的逻辑折叠需要从底层重写EDA,因为现有EDA是"为二维平面设计优化"的,不支持3D逻辑折叠的全流程设计。华为已经发布了TEDA EDA工具链,完整覆盖3D逻辑折叠芯片从架构规划到落地的全设计流程。这是6年381款芯片"踩坑踩出来的",美国三大EDA巨头(Synopsys、Cadence、Siemens)要复制,需要从零开始。
第三,没有"软硬芯全栈协同"的组织基因。何庭波原话讲得很清楚:"华为比同行更早遇到这堵墙"。这堵墙是制裁砌起来的,但也逼出了华为在"软件、架构、芯片全栈协同"的独有能力。美国巨头要复制,需要重构组织模式,而组织重构比技术重构难十倍。
类似的故事在产业史上也有过:丰田公开精益生产的所有原则,但通用汽车花了30年都没完全学会。原则可以复制,组织能力和工程秘方复制不了。
三、理论公开无损于优势,工程领先保底5-10年
回到一个尖锐的问题:华为公布韬定律细节,会不会自毁前程?
我的判断是:华为不仅不是自毁前程,反而是一步极高明的棋。
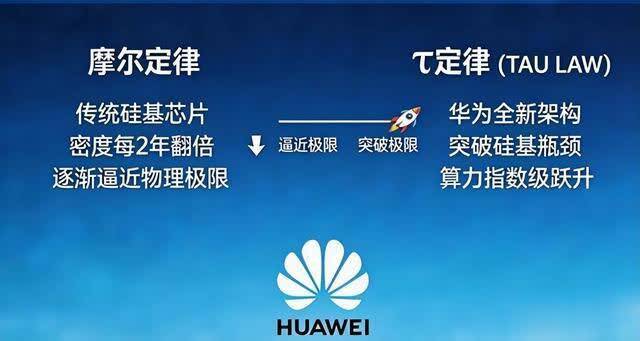
第一,公开韬定律是"定义赛道"的战略行为。何庭波在论文里明确说:"未来一定属于开放合作"。华为要的不是藏着韬定律自己用,而是要让韬定律成为后摩尔时代的全球新范式,一旦行业接受"时间缩微替代几何缩微"这把新尺子,华为就是这把尺子的定义者,享有类似英特尔定义摩尔定律的范式红利。那这条赛道里,华为就是标杆!
第二,公开细节是"倒逼自己"的阳谋。论文是预印本,意味着接受全球同行评审和挑战。华为敢拿出来,大概率内部已经有V4、V5的技术储备,而这是IT行业的经典打法:你看到的是我已经成熟的,我藏着的是下一代更领先的。
第三,真正的护城河在工程层,不在理论层。何庭波公开的"逻辑折叠""3D混合键合"是方向,华为有"TEDA V0.1 EDA工具链"、"381款芯片迭代数据"、"全栈协同组织能力"是实现路径。方向可以学,工具链和组织能力不是短期学来的。
第四,即使在更先进制程上用韬定律,美国系也未必能反超。这里有一个关键的反直觉点:在3纳米、1.5纳米制程工艺上做3D堆叠,晶体管本身的量子隧穿漏电就已经很高,3D堆叠的热量会指数级放大。华为用"成熟制程+逻辑折叠"把功耗压下来,是因为成熟制程的晶体管本身漏电流小、热密度低,给了3D堆叠的空间。美国同行在先进制程上进行直接堆叠,要付出的热管理、良率、EDA重构代价,可能比华为在成熟制程上做逻辑折叠更高。韬定律的收益有边际递减,不是堆叠越激进收益越大。
四、国产光刻机的"渐进突破"作为双重保险
必须泼一盆冷水:EUV商业化量产,现实目标在2030年前后。
基于公开权威信源的客观进展:
28纳米浸没式DUV:2025年成功推出并通过验收,2026年初完成全流程工艺验证,晶圆流片良率稳定超90%,进入量产交付阶段,核心部件国产化率突破85%
EUV光刻机:国内首台EUV光刻原型机已完成组装,成功生成13.5纳米极紫外光,完成初步光刻试验;中科院上海光机所LPP-EUV光源能量转换效率超越欧洲团队、接近商用标准,实现千瓦级功率输出;哈工大DPP-EUV光源稳定43W+输出,连续1000小时无故障
量产预期:行业理性观点认为2030年才可能实现小规模量产;《外交官》杂志援引业内人士称,利用原型机制造出可用芯片的"现实目标"是2030年
所以华为的真实底气结构是:70%来自应用层与工具链的遥遥领先,30%来自国产光刻设备的渐进突破作为未来加码。华为不是赌EUV明天就量产,而是哪怕EUV还需要4-5年才量产,华为在成熟制程+逻辑折叠的赛道上未来能打出"等效1.4纳米"的牌。何庭波在5月论文里披露的路线规划是:2031年高端芯片晶体管密度达到1.4纳米制程同等水平。
这是一道双保险:
近期(2026-2030):依靠韬定律+逻辑折叠+成熟制程,在7纳米平台上做出"等效3纳米甚至1.4纳米"的性能
远期(2030+):国产EUV量产,华为在先进制程上再叠加逻辑折叠,形成"制程+架构"的双叠加优势
五、一个IT老兵的冷静判断
回到文章的标题:华为的底气到底来自哪里?
不是来自"理论保密",理论早就公开了。
不是来自"EUV马上量产",EUV商业化还要4-5年。
而是来自三个美国同行短期追不上的东西:
一是6年381款芯片的工程迭代数据。这是用时间换来的、无法压缩的经验护城河。
二是TEDA V0.1 EDA工具链+全栈协同组织能力。这是用"被制裁"换来的、美国同行无法复制的组织基因。
三是"以时间τ缩微替代几何缩微"的范式定义权。这是华为在下一代半导体话语体系里抢到的座位。未来十年,行业讨论"芯片进步"的标尺,可能就是华为定义的τ。
何庭波在V3论文里写了一句话,值得所有科技观察者深思:
"我们能预见的τ的每一个未来,都成于功耗、亦败于功耗。时间余量是手段,能量才是锦标。"
这句话的潜台词是:华为已经跑在这条赛道领跑6年了,你们追吧。
这不是一时冲动,这是经过6年工程验证后的战略摊牌。既然已经跑在前面,不如把赛道定义权拿过来,让全行业跟着华为的尺子走。这步棋,英特尔在1965年定义摩尔定律时走过一次,华为是第二个这么干的中国公司。一旦成功,华为必将载入史册。
作为冷静的产业观察者,最终定论要等两个时间点验证:一是麒麟2026商用后的真实用户口碑(纸面数据再漂亮,也不如实际体验);二是2031年"等效1.4纳米"目标的兑现情况。在此之前,华为的"自信"是有坚实依据的强置信判断,但不是已被完全验证的产业定论。
但有一点可以确定:当何庭波把V3论文挂到ChinaXiv上的那一刻,全球半导体产业的竞争坐标系,已经悄悄地从"纳米数"切换到了"τ值"。而这一次,定义新坐标的,是一家中国公司。
你对华为公开韬定律细节这步棋怎么看?是"自毁前程"还是"定义赛道"?欢迎在评论区聊聊你的判断。
金鼎配资提示:文章来自网络,不代表本站观点。